AML Rules Engine entwickeln: Architektur für die Transaktionsüberwachung
Eine AML Rules Engine überprüft einen kontinuierlichen Strom von Transaktionen, um diejenigen zu identifizieren, die eine manuelle Prüfung erfordern. Auf den ersten Blick mag dieser Prozess wie eine einfache Filterung erscheinen. Doch spätestens dann, wenn ein Compliance-Beauftragter am Freitag einen neuen Schwellenwert anfordert und erwartet, dass dieser bereits am Montag produktiv eingesetzt wird, zeigt sich, wie komplex die Aufgabe tatsächlich ist. Angenommen, Sie setzen die Änderung um: Was passiert, wenn die Aufsichtsbehörden zwei Jahre später wissen möchten, warum eine bestimmte Warnmeldung ausgelöst wurde? Und wie gehen Sie damit um, wenn Analysten weniger Warnmeldungen fordern und gleichzeitig Ihr Entwicklungsteam für steigende Latenzzeiten verantwortlich gemacht wird?
In diesem Artikel erfahren Sie, wie Sie diese Herausforderungen bewältigen, indem Sie eine konfigurierbare Rules Engine für die regelbasierte Transaktionsüberwachung entwickeln. Dabei geht es darum, Transaktionsereignisse zu verarbeiten, Schwellenwerte und Abhängigkeiten zu verwalten, die Erkennungslogik zu versionieren und eine lückenlose Audit-Trail-Dokumentation sicherzustellen.
Welche Aufgaben muss die Engine erfüllen?
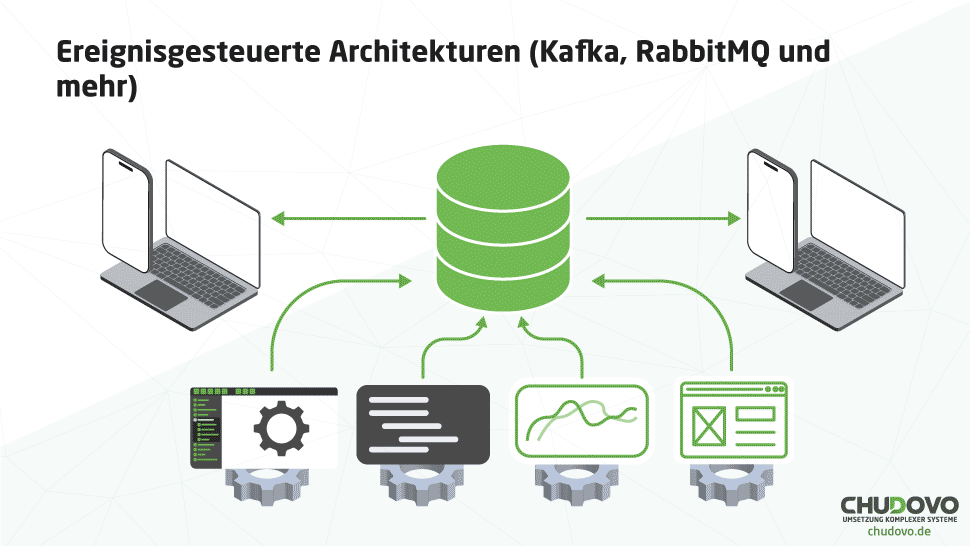
Jedes AML-System zur Transaktionsüberwachung empfängt Ereignisse, ergänzt diese um Kunden- und Kontoinformationen, prüft die angereicherten Daten anhand von Erkennungsregeln und erzeugt Warnmeldungen mit ausreichenden Informationen, damit ein Analyst eine Entscheidung treffen kann. Während die Verarbeitung eingehender Ereignisse bereits für zahlreiche unterschiedliche Dienste umgesetzt wurde, bereiten vor allem die Regelauswertung und die Kontextanreicherung Schwierigkeiten. Das folgende Diagramm zeigt vereinfacht, wie dieser Ablauf aussieht:
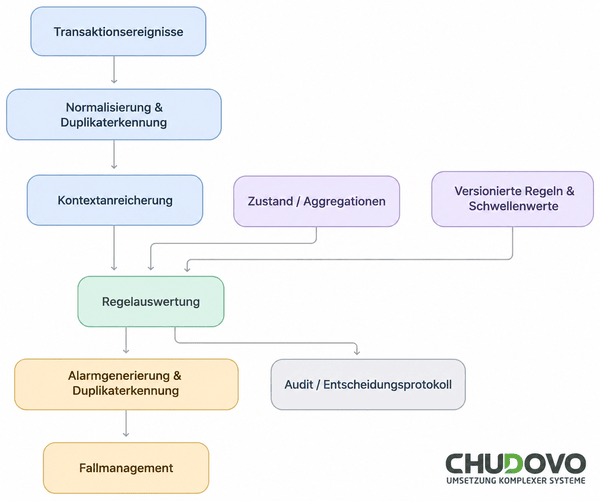
In den meisten Fällen muss das System zwei Arten von Regeln unterstützen: Regeln, die einzelne Transaktionen prüfen (beispielsweise eine Regel, die jede Überweisung oberhalb eines bestimmten Betrags markiert), und Regeln, die das Verhalten über einen längeren Zeitraum analysieren. Ein Beispiel für Letzteres wäre eine Regel, die zehn kleine Einzahlungen erkennt, auf die innerhalb von 48 Stunden eine große Überweisung folgt. Die erste Regel ist zustandslos (stateless), während die zweite einen gespeicherten Zustand benötigt, um eine Kombination von Ereignissen innerhalb eines bestimmten Zeitraums auszuwerten.
Aufbau von AML-Erkennungsregeln
Eine schnelle Möglichkeit, Regeln für die Transaktionsüberwachung zu Beginn eines Projekts umzusetzen, besteht darin, sie direkt im Code festzulegen. Nach drei Monaten ist dann jedoch für jede Anpassung eines Schwellenwerts ein neues Release erforderlich. Besser ist es, eine konfigurierbare Rules Engine zu entwickeln, in der die Regeln als Daten gespeichert werden. Jeder Regeleintrag enthält außerdem Metadaten wie eine Kennung, eine Version, einen Geltungsbereich, eine Bedingung, Parameter und eine Aktion. Die Bedingungen sollten möglichst eng gefasst sein, damit ihre Wartung nicht unnötig kompliziert wird. Wenn Sie feststellen, dass Sie eine vollständige Programmiersprache benötigen, um eine Bedingung zu definieren, sollten Sie darüber nachdenken, die betreffende Regel aufzuteilen.
Ein weiterer Tipp: Halten Sie Bedingungen und Parameter getrennt. Betrachten wir dazu ein Beispiel: Eine Bedingung legt fest, dass die Summe der Bareinzahlungen innerhalb eines bestimmten Zeitfensters einen Grenzwert erreicht. Die Parameter definieren hingegen den Schwellenwert und das Zeitfenster. Bei diesem Ansatz bleibt eine Parameteränderung innerhalb derselben Bedingung, während eine Änderung der Logik eine separate Überprüfung erfordert.
Das Team von Chudovo verwendet für konfigurierbare Rules Engines eine Regeldefinition wie im folgenden Beispiel:
{
"rule_id": "STRUCT-CASH-01",
"version": 7,
"scope": { "segment": ["retail"], "channel": ["cash_deposit"] },
"condition": {
  "aggregate": "sum",
  "field": "amount_usd",
  "window": "48h",
  "group_by": "account_id",
  "operator": ">=",
  "limit": "$limit",
  "min_count": "$min_count"
},
"parameters": { "limit": 9000, "currency": "USD", "min_count": 3 },
"action": { "type": "alert", "severity": "medium" },
"effective_from": "2026-07-01T00:00:00Z"
}
Die Regel gruppiert Bareinzahlungen nach Konto und summiert sie über einen Zeitraum von 48 Stunden. Sobald der Schwellenwert erreicht wird und mindestens drei Einzahlungen dazu beigetragen haben, wird eine Warnmeldung mit mittlerem Schweregrad ausgelöst. Dieses Beispiel richtet sich an Privatkunden. Deshalb verwenden wir das Feld „scope“, um zu verhindern, dass bei Geschäftskonten mit hohem Bargeldaufkommen eine Warnmeldung ausgelöst wird.
Ereignisverarbeitung
Manche Entscheidungen müssen getroffen werden, bevor Gelder transferiert werden. In anderen Fällen erfolgt die Transaktionsüberwachung asynchron, um verdächtige Aktivitäten nach der Ausführung zu erkennen. Je nach Anwendungsfall können sich Teams für Streaming, Batch-Verarbeitung oder eine Kombination aus beiden entscheiden. Streaming eignet sich für den ersten Fall, da es eine Regelauswertung mit geringer Latenz ermöglicht. Für die Analyse von Aktivitäten über längere Zeiträume ist die Batch-Verarbeitung besser geeignet.
Eine weitere Entscheidung betrifft die Verwendung von Sliding Windows oder Tumbling Windows. Wenn das System Structuring-Muster erkennen soll, sind Sliding Windows die bessere Wahl. Allerdings verursachen sie einen höheren Aufwand bei der Verarbeitung und Zustandsverwaltung. Dies sollte bei der Planung berücksichtigt werden.
Die Genauigkeit hängt auch davon ab, wie das System mit verspätet eintreffenden oder in falscher Reihenfolge verarbeiteten Transaktionen umgeht. Ein gut konzipiertes System verwendet die Ereigniszeit (Event Time) und erkennt Duplikate anhand der Transaktions-ID. Auch die Warnmeldungen selbst müssen dedupliziert werden. Denn sobald ein Schwellenwert innerhalb eines Zeitfensters überschritten wird, können nachfolgende Transaktionen dieselbe Warnmeldung erneut auslösen. In diesem Fall sollte das System die neuen Informationen der bestehenden Warnmeldung hinzufügen, anstatt eine neue zu erstellen.
In der Phase der Kontextanreicherung ergänzt das System zusätzliche Kundeninformationen, damit die Regeln eine korrekte Auswertung durchführen können. Wichtig ist dabei, die tatsächlich verwendeten Werte zusammen mit der Entscheidung zu speichern. Reine Verweise auf Kundendaten reichen nicht aus, da sich diese Daten im Laufe der Zeit ändern können.
Schwellenwerte gelten üblicherweise für bestimmte Kundensegmente. Um ihre Verwaltung zu vereinfachen, sollten sie als Parametersätze gespeichert werden, die den jeweiligen Segmenten zugeordnet und von der Regellogik getrennt sind. Jede Änderung sollte dem Vier-Augen-Prinzip (Maker-Checker-Prinzip) unterliegen, damit das System jeden Schritt dokumentiert. Wird ein neuer Schwellenwert eingeführt, sollte er anhand historischer Daten getestet werden. Dafür können Teams sogenannte Below-the-Line-Tests durchführen. Beispielsweise lässt sich ein Monat an Transaktionsdaten mit dem neuen Schwellenwert erneut verarbeiten. Die Ergebnisse werden dokumentiert und mit den bisherigen Ergebnissen verglichen.
Abhängigkeiten
Regelabhängigkeiten können sowohl in den Daten als auch in der Systemlogik bestehen. Ein Beispiel für Ersteres ist eine verhaltensbasierte Regel, die auf einem 90-Tage-Durchschnitt basiert, der von einem anderen Prozess berechnet wird. Ein Beispiel für Letzteres wäre eine Regel, die nur dann ausgelöst werden kann, wenn zuvor bereits eine andere Regel ausgelöst wurde.
Teams müssen diese Abhängigkeiten als gerichteten azyklischen Graphen (Directed Acyclic Graph, DAG) modellieren. Außerdem müssen die Abhängigkeiten bei der Veröffentlichung validiert und zyklische Abhängigkeiten abgelehnt werden. Anschließend kann die Engine die Regeln anhand ihrer Abhängigkeiten in die richtige Ausführungsreihenfolge bringen und unabhängige Regeln parallel ausführen.
Manche Abhängigkeiten lassen sich nur schwer nachvollziehen. Beispielsweise könnte Regel C nur dann ausgelöst werden, wenn zuvor Regel B ausgelöst wurde. Regel B wiederum hängt von Regel A ab. Wenn jemand wissen möchte, warum Regel C nicht ausgelöst wird, muss der Abhängigkeitspfad über die beiden anderen Regeln rekonstruiert werden. Um dies zu vereinfachen, implementieren Entwickler häufig einen Score-Aggregator: Jede Regel erzeugt ein Signal mit einer bestimmten Gewichtung. Der Aggregator summiert diese Werte, und sobald der Gesamtscore einen festgelegten Schwellenwert überschreitet, wird eine entsprechende Warnmeldung ausgelöst. Um die Nachvollziehbarkeit sicherzustellen, ist es wichtig, festzuhalten, welchen Beitrag jedes einzelne Signal zur Warnmeldung geleistet hat.
Unterdrückungsregeln (Suppression Rules) erfordern dieselbe Sorgfalt, da sie andernfalls zu blinden Flecken in der Überwachung führen können. Für jede Unterdrückung sollten die verantwortliche Person und gegebenenfalls ein Ablaufdatum angegeben werden.
Versionierung
Auch wenn das System seine Regeln ändern kann, sollte jede einzelne Regel unveränderlich sein. Das ist kein Widerspruch, sondern eine bewusste Designentscheidung.
Wie funktioniert das? Jede Regel erhält eine eigene Version, die nach ihrer Erstellung nicht mehr bearbeitet werden kann. Jede Änderung erfordert eine neue Version, während die vorherige für die Historie erhalten bleibt. Jede Version enthält außerdem ein Datum, ab dem sie gültig ist (effective-from). Wird sie außer Betrieb genommen, wird zusätzlich ein Enddatum (effective-to) erfasst. Beide Angaben definieren den Gültigkeitszeitraum der Regel. Das ist besonders hilfreich, wenn nachvollzogen werden muss, welche Regel an einem bestimmten Tag aktiv war.
Rollbacks funktionieren nach demselben Prinzip: Dabei wird eine frühere Version reaktiviert, ohne die aktuelle Version zu verändern.
Da Ereignisse verspätet eintreffen können, benötigt das System eine klare Richtlinie, anhand derer entschieden wird, welche Regel auf das jeweilige Ereignis anzuwenden ist. Diese Information sollte zusammen mit den übrigen Daten gespeichert werden, da sie benötigt wird, um das ursprüngliche Ergebnis bei einer erneuten Verarbeitung (Replay) zu reproduzieren.
Teams können eine Spalte einrichten, in der der Status einer Regelversion gespeichert wird, beispielsweise Draft, Review, Shadow, Active oder Retired. Der Shadow-Modus wird häufig verwendet, um eine vorgeschlagene Version vor ihrer produktiven Aktivierung zu testen. Dabei führt das System diese Version parallel zur aktiven Version aus, ohne die dabei erzeugten Protokolle an die Analysten weiterzuleiten. Entwickler können die Ergebnisse dennoch nutzen, um sie mit dem aktuellen Verhalten des Produktivsystems zu vergleichen.
Eine weitere Frage, über die Teams diskutieren, ist, wo die maßgebliche Datenquelle (Source of Truth) liegen sollte. Einige bevorzugen Git, da es Versionsvergleiche, Reviews und eine Änderungshistorie ermöglicht. Andere halten eine Datenbank für geeigneter, weil sie schnelle Abfragen zur Laufzeit unterstützt. Bei einem hybriden Ansatz werden die Regeln in Git verwaltet und über eine Pipeline in einer Datenbank veröffentlicht. Dadurch werden Versionsverwaltung und Datenzugriff zur Laufzeit voneinander getrennt.
Audit-Trail
Wenn eine Warnmeldung ausgelöst wird, ist ein Entscheidungsprotokoll erforderlich, aus dem hervorgeht, welche Regel beteiligt war, welche Version und Parameter verwendet wurden, welche Eingabewerte vorlagen und wer die Änderung genehmigt hat. Ein geeigneter Speicherort dafür ist ein schreibgeschützter Datenspeicher, der die tatsächlich für die Entscheidung verwendeten Werte enthält. Es sollte vermieden werden, lediglich Verweise zu speichern, da sich die zugrunde liegenden Daten im Laufe der Zeit ändern können.
Es ist außerdem sinnvoll, Ereignisse zu protokollieren, bei denen keine Warnmeldung ausgelöst wurde. So lässt sich erklären, warum innerhalb eines bestimmten Zeitraums keine Warnmeldung erzeugt wurde. Da die Speicherung vollständiger Snapshots aller Eingabedaten kostspielig sein kann, sollten nur die Informationen erfasst werden, die erforderlich sind, um eine Auswertung bei Bedarf zu rekonstruieren. Übersprungene Regeln und fehlgeschlagene Auswertungen müssen getrennt erfasst werden, da es sich um unterschiedliche Sachverhalte handelt.
In jedem Fall muss die Regelauswertung deterministisch sein, damit eine erneute Verarbeitung die erwarteten Ergebnisse liefert.
Performance-Aspekte
Der eigentliche Engpass liegt beim Datenzugriff und nicht bei der Anzahl der Regeln. Hundert einfache Regeln verursachen weniger Aufwand als fünf zeitfensterbasierte Aggregationen über Konten mit großen Datenmengen. Um solche Engpässe zu vermeiden, besteht ein möglicher Ansatz darin, Regeln nach ihrem Geltungsbereich zu indexieren. Dies lässt sich mit einer Vorfilterung nach Kundensegment und Kanal kombinieren, bevor die jeweilige Auswertung beginnt. Müssen Aggregationen berechnet werden, sollten diese inkrementell erfolgen. Die Zähler werden dabei in Zeitintervallen (Time Buckets) verwaltet, wobei veraltete Einträge automatisch entfernt werden.
Teams können auch mit einem Händler konfrontiert werden, der so viele Ereignisse erzeugt, dass ein Worker überlastet wird. In diesem Fall können sie das betreffende Konto auf einen separaten Verarbeitungspfad verlagern und versuchen, seine Transaktionen auf mehrere Worker aufzuteilen. Dabei ist jedoch zu beachten, dass für zustandsbehaftete Regeln weiterhin eine gewisse Aggregation erforderlich ist.
Häufige Herausforderungen bei der Implementierung
Im Laufe der Jahre sammeln sich in einem regelbasierten System häufig Hunderte von Regeln an, die sich teilweise überschneiden. Dadurch wird die Wartung des Systems erschwert, denn niemand möchte Code verändern, der schon lange existiert und dessen ursprünglicher Zweck nicht mehr bekannt ist. Um den Code übersichtlich zu halten, empfiehlt es sich, die Regeln regelmäßig zu überprüfen, in der Regel zweimal pro Jahr. Dabei sollten die von den einzelnen Regeln erzeugten Warnmeldungen analysiert und wenig wirksame Regeln außer Betrieb genommen werden.
Eine Rules Engine ist nur so gut wie die Daten, die sie verarbeitet. Fehlerhafte Eingabewerte, beispielsweise fehlende Angaben zum Land der Gegenpartei oder uneinheitliche Währungen, können dazu führen, dass Regeln unbemerkt fehlschlagen, wenn solche Fälle nicht berücksichtigt werden. Teams sollten deshalb Eingabedaten grundsätzlich validieren und Fehler ausdrücklich melden, wenn sich die Daten nicht bereinigen lassen. Bei Währungsumrechnungen sollte der Wechselkurs zum Zeitpunkt des Ereignisses verwendet und zusammen mit der Entscheidung dokumentiert werden, um deren Grundlage nachvollziehbar zu machen.
Eine weitere häufige Fehlerquelle sind unzureichende Tests. Entwickler schreiben üblicherweise Unit-Tests für einzelne Bedingungen und verlassen sich anschließend vollständig auf deren Ergebnisse. Das reicht jedoch nicht aus. Um Regressionen vor dem Produktiveinsatz zu erkennen, müssen Teams Testszenarien für jede Typologie planen und entsprechende Testdatensätze erstellen. Dies gilt insbesondere für Structuring-Muster oder schnelle Geldbewegungen.
Wenn es erstmals zu Meinungsverschiedenheiten über die Anzahl der Warnmeldungen kommt, ist es hilfreich, klare Zuständigkeiten schriftlich festgelegt zu haben. Üblicherweise ist die Compliance-Abteilung für die Schwellenwerte verantwortlich, während das Entwicklungsteam die Verantwortung für die Plattform trägt.
In einem vorherigen Abschnitt haben wir erläutert, warum die Sprache zur Definition von Bedingungen möglichst eng gefasst sein sollte. Dies kann jedoch in bestimmten Fällen schwierig sein, insbesondere bei Typologien, die Graphanalysen oder statistische Modelle erfordern. Kriminelle passen ihre Vorgehensweisen schnell an und entwickeln sie weiter. Deshalb müssen sich auch die Erkennungsregeln entsprechend weiterentwickeln. Ein möglicher Ansatz besteht darin, später Anomalieerkennungsmodelle hinzuzufügen und die Rules Engine als nachvollziehbare Grundlage beizubehalten.
Fazit
Für die Entwicklung einer leistungsfähigen AML Rules Engine reicht es nicht aus, lediglich eine gut durchdachte Sammlung von Regeln zu erstellen. Das System muss Transaktionen zuverlässig verarbeiten, Änderungen ermöglichen, ohne die bestehende Logik zu beeinträchtigen, und nachvollziehbar erklären können, warum eine bestimmte Warnmeldung ausgelöst wurde. Selbst Teams, die auf vorgefertigte AML-Compliance-Software zurückgreifen, stehen bei deren Anpassung vor den meisten dieser Architekturentscheidungen.
Bei der Entwicklung von AML-Software kommt es vor allem darauf an, mit einer überschaubaren Anzahl konfigurierbarer Regeln zu beginnen. Darauf aufbauend sollten Mechanismen für Versionierung, Tests und Auditierung implementiert werden. Sobald diese Grundlagen geschaffen sind, lassen sich weitere Erkennungsszenarien einfacher hinzufügen.