ETA-Prognosen und Exception Management in Logistiksystemen: Technische Umsetzung
Die Echtzeit-Sendungsverfolgung ermöglicht es Kunden, den aktuellen Standort ihrer Sendung nachzuvollziehen. Die meisten Tracking-Systeme können jedoch nicht zuverlässig vorhersagen, ob eine Sendung pünktlich oder verspätet zugestellt wird. Das führt häufig dazu, dass verärgerte Kunden den Kundensupport kontaktieren.
Dieser Artikel beleuchtet die technischen Prozesse hinter der Sendungsverfolgung. Er zeigt, wie Ereignisdaten von Transportunternehmen in die ETA-Prognose einfließen, anhand welcher Kriterien das System Abweichungen vom geplanten Transportverlauf erkennt und wie diese im Rahmen des Exception Managements behandelt werden. Im Mittelpunkt stehen die technische Implementierung und die Architektur eines Tracking-Systems.
Als Grundlage dient ein Szenario mit mehreren Transportunternehmen und unterschiedlichen Datenquellen: Webhooks, regelmäßig abgefragte REST-Endpunkte, EDI-Nachrichten und kontinuierlich übertragene Telematikdaten.
Überblick über die Verarbeitungspipeline
Betrachten wir zunächst die gesamte Verarbeitungspipeline:
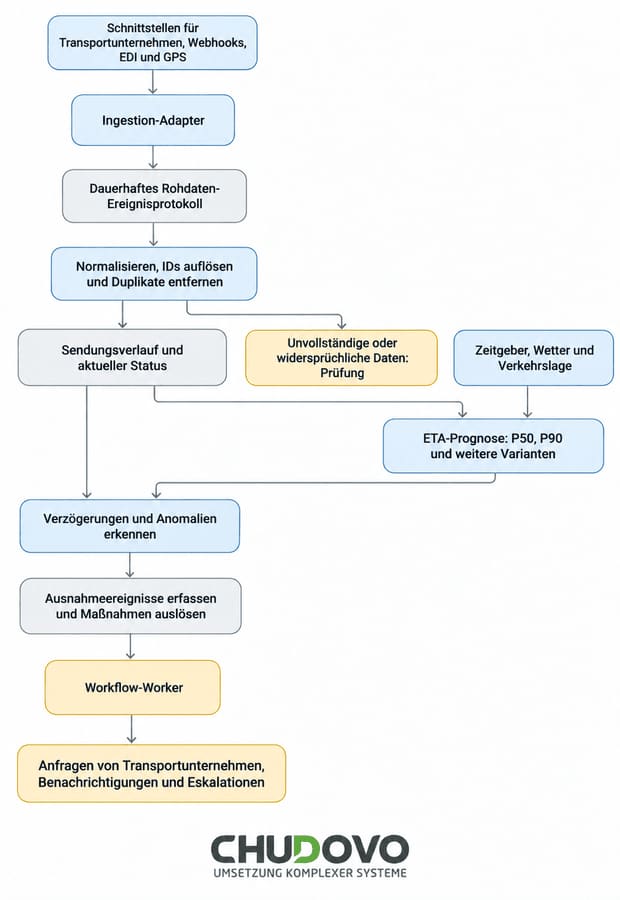
Ein System zur Vorhersage der voraussichtlichen Ankunftszeit (Predictive ETA) lässt sich in fünf Phasen unterteilen:
- Das Transportunternehmen übermittelt ein Rohereignis.
- Das System normalisiert das Ereignis, indem es dieses einem Ereignistyp des internen Datenmodells zuordnet.
- Ein Zustandsspeicher (State Store) hält den aktuellen Status jeder Sendung vor.
- Ein Prognosedienst berechnet den Median der voraussichtlichen Ankunftszeit sowie eine obere Schätzung des Ankunftszeitpunkts.
- Eine Regelebene entscheidet, ob die Abweichung zwischen der prognostizierten und der geplanten Ankunftszeit ein manuelles Eingreifen erfordert oder durch eine automatisierte Aktion behandelt werden kann.
Externe Abhängigkeiten können den Ablauf in der Praxis beeinflussen. Fällt beispielsweise die API eines Transportunternehmens aus, wirkt sich dies auf die Daten aus, die das System empfängt. Um zu verhindern, dass der ETA-Dienst dadurch zum Stillstand kommt, werden die einzelnen Phasen der Verarbeitung logistischer Ereignisse häufig durch persistente Ereignisprotokolle voneinander entkoppelt. Dafür verwenden Entwicklungsteams meist Kafka. Grundsätzlich eignet sich jedoch jedes Log-System, das eine erneute Verarbeitung gespeicherter Ereignisse (Replay) unterstützt.
Die Möglichkeit zur erneuten Verarbeitung ist besonders wichtig, wenn ein Fehler bei der Zuordnung von Ereignissen behoben werden muss. Nach der Fehlerbehebung lassen sich der Sendungsstatus und die ETA anhand der gespeicherten Ereignisse rekonstruieren. Dabei müssen externe Aktionen deaktiviert bleiben, damit Benachrichtigungen nicht erneut versendet und externe Vorgänge, beispielsweise Anfragen an Transportunternehmen, nicht wiederholt werden.
Erfassung von Sendungsereignissen
Die Daten der Transportunternehmen werden über Webhooks, regelmäßig abgefragte REST-APIs, EDI-214-Statusmeldungen sowie GPS- und Telematikdatenströme bereitgestellt. Diese Datenquellen unterscheiden sich hinsichtlich ihrer Latenz und Zuverlässigkeit. Webhooks sind in der Regel eine gute Wahl, wenn Daten möglichst schnell übertragen werden sollen. Allerdings unterscheiden sich die Verfahren zur Wiederholung fehlgeschlagener Übertragungen je nach Transportunternehmen. Regelmäßige API-Abfragen (Polling) bieten mehr Kontrolle über den Datenabruf, verursachen jedoch höhere Verzögerungen. EDI-Nachrichten werden üblicherweise gebündelt übertragen und treffen mitunter erst mehrere Stunden nach dem tatsächlichen Ereignis ein.
Unabhängig vom Übertragungsweg sollte das System die empfangenen Rohdaten unmittelbar und noch vor der Verarbeitung oder Empfangsbestätigung dauerhaft speichern. Nur so lässt sich später genau nachvollziehen, welche Informationen das Transportunternehmen ursprünglich übermittelt hat. Entwicklungsteams speichern diese Daten üblicherweise in einem Objektspeicher oder einer Append-only-Tabelle. Zusätzliche Metadaten wie die Datenquelle, der Empfangszeitpunkt und ein Hashwert erleichtern das spätere Auffinden der Datensätze.
Entwickler müssen außerdem doppelte Ereignisübertragungen und Datenlücken berücksichtigen, die entstehen können, wenn sämtliche Wiederholungsversuche fehlschlagen. Dafür eignet sich vorzugsweise eine Ereignis-ID, die innerhalb der jeweiligen Datenquelle eindeutig ist. Alternativ lässt sich ein Deduplizierungsschlüssel aus der Kennung des Transportunternehmens, der Sendungsreferenz, dem Statuscode, dem Ereigniszeitpunkt und dem Standort bilden. Das System muss außerdem ausdrücklich übermittelte Korrekturen von duplizierten Ereignissen unterscheiden können.
Damit die Ereignisprotokolle möglichst vollständig bleiben, sollten notwendige Zurückweisungen erst auf der Ebene der Consumer und nicht bereits beim Eingang der Daten erfolgen.
Jedes Ereignis besitzt einen Ereigniszeitpunkt (Event Time), der angibt, wann es tatsächlich stattgefunden hat. Hinzu kommt der Erfassungszeitpunkt (Ingest Time), zu dem das System das Ereignis empfängt. Diese beiden Zeitpunkte sind nicht zwangsläufig identisch und spielen, wie wir später sehen werden, unterschiedliche Rollen bei der ETA-Berechnung.
Der Zustandsspeicher sollte für jede Sendung einen eigenen Datensatz enthalten. Darin werden unter anderem der aktuelle Status, die zuletzt bekannte Position, die geplante Route, der Verlauf der Transportmeilensteine sowie die aktuelle ETA einschließlich ihrer Versionsnummer gespeichert. Für schnelle Lesezugriffe eignen sich Redis oder ein kompaktiertes Kafka-Topic. Historische Daten lassen sich in einer relationalen Datenbanktabelle speichern.
Normalisierung von Ereignisdaten
Jedes Transportunternehmen entwickelt seine eigene API und verwendet dabei eigene Bezeichnungen und Statuscodes. In einem System, das mehrere Transportunternehmen integriert, kann ein Anbieter beispielsweise „ODF“ übermitteln, während ein anderer „Out for Delivery“ verwendet. Ein dritter Anbieter könnte denselben Status mit dem numerischen Code „21“ kennzeichnen. Werden all diese unterschiedlichen Werte direkt in der Kernlogik verarbeitet, steigt die Komplexität des Systems und damit auch das Fehlerrisiko.
Die Lösung besteht in einer Normalisierungsschicht, die sämtliche erwarteten Statuswerte auf eine begrenzte Anzahl einheitlicher, intern verwendeter Zustände abbildet. Dazu lässt sich beispielsweise eine Liste zulässiger Statuswerte definieren: erstellt, abgeholt, unterwegs, am Umschlagplatz eingetroffen, Umschlagplatz verlassen, in Zustellung, zugestellt, Ausnahmefall und retourniert. Sobald ein Ereignis von einem Transportunternehmen eingeht, ordnet die Normalisierungsschicht den übermittelten Wert einem dieser internen Zustände zu. Wird später ein weiteres
Transportunternehmen angebunden, sind lediglich kleinere Anpassungen an der Zuordnungslogik erforderlich. Dasselbe gilt, wenn ein bestehender Anbieter die Struktur seiner API ändert.
Während die Normalisierungslogik im Anwendungscode implementiert ist, sollten die Zuordnungen der Statuswerte als Daten gespeichert werden, idealerweise in einer versionierten Tabelle. Auf diese Weise lassen sich fehlerhafte Zuordnungen korrigieren, ohne dass eine neue Version der Anwendung bereitgestellt werden muss.
Eine Normalisierung ist auch dann empfehlenswert, wenn zunächst nur die Integration eines einzigen Transportunternehmens geplant ist. Sie erleichtert eine spätere Erweiterung auf mehrere Anbieter und verhindert, dass die bestehende Kernlogik dafür grundlegend angepasst werden muss.
Das Entwicklungsteam von Chudovo achtet darauf, dass das kanonische Ereignismodell kompakt bleibt und klar definierten Regeln folgt. Hier ist eine vereinfachte Version in Python:
@dataclass(frozen=True)
class ShipmentEvent:
shipment_id: str
carrier: str
status: str # canonical status
event_time: datetime # when it happened, UTC
ingest_time: datetime # when we received it, UTC
location: Optional[GeoPoint]
raw_ref: str # pointer to the raw payload
mapping_version: int
def normalize(raw, mapping):
status = mapping.lookup(raw.carrier, raw.code)
if status is None:
return UnmappedEvent(raw_ref=raw.ref) # goes to review queue
return ShipmentEvent(
shipment_id=resolve_shipment(raw.carrier, raw.shipment_ref),
carrier=raw.carrier,
status=status,
event_time=to_utc(raw.timestamp, raw.facility_tz),
ingest_time=raw.ingest_time,
location=raw.location,
raw_ref=raw.ref,
mapping_version=mapping.version,
)Vor jeder Aktualisierung des Sendungsstatus müssen die Referenzen des Transportunternehmens einer internen Sendungs-ID zugeordnet werden. Wird keine eindeutige Übereinstimmung gefunden oder sind die Referenzen mehrdeutig, sollte der betreffende Datensatz zur manuellen Prüfung weitergeleitet werden. Eine fehlerhafte Zuordnung kann die ETA-Berechnung unbemerkt verfälschen.
Datenqualität hat oberste Priorität
Bei der Verarbeitung von Echtzeitdaten in der Logistik treten täglich zahlreiche Probleme auf: Ereignisse treffen in der falschen Reihenfolge ein, werden mehrfach übermittelt, Scans fehlen, Zeitzonen sind falsch angegeben oder Standortdaten sind unplausibel. Jedes dieser Probleme erfordert eine gezielte Behandlung.
Ereignisse, die nicht in chronologischer Reihenfolge eintreffen, werden üblicherweise nachträglich in den Verlauf der Transportmeilensteine eingefügt. Der aktuelle Sendungsstatus wird dabei nur aktualisiert, wenn die definierten Regeln für Statusübergänge dies zulassen. Bei fehlenden Scans sollte das System die Datenlücke ausdrücklich kennzeichnen. Ein übersprungener Transportschritt darf nur dann abgeleitet werden, wenn der nachfolgende Status eindeutig darauf schließen lässt.
Zeitzonen sind eine häufige Fehlerquelle, da viele Transportunternehmen lokale Zeitangaben ohne Angabe des UTC-Offsets übermitteln. Die Umrechnung sollte bereits bei der Datenerfassung erfolgen, wobei die jeweilige Zeitzone anhand des Standorts der Logistikeinrichtung ermittelt wird. In dieser Phase sollte das System auch unplausible Standortwechsel erkennen, kennzeichnen und von der weiteren Verarbeitung ausschließen. Ein Beispiel wäre ein Lkw, der laut den empfangenen Daten innerhalb von zehn Minuten eine Strecke von 800 Kilometern zurückgelegt hat.
Für jede Datenquelle sollte ein eigener Qualitätswert ermittelt werden. Entwicklungsteams müssen diesen kontinuierlich überwachen und Kennzahlen wie die Verzögerung bei der Datenübermittlung, den Anteil duplizierter Ereignisse und den Anteil nicht zugeordneter Statuswerte für jedes Transportunternehmen erfassen. Diese Informationen sind auch für das ETA-Prognosemodell relevant. So lässt sich beispielsweise überprüfen, ob die Vorhersagen für ein Transportunternehmen mit verzögerter EDI-Datenübermittlung weiterhin gut kalibriert sind.
ETA-Prognosen in der Logistik
Bevor Entwicklungsteams verschiedene Prognosemodelle in Betracht ziehen, müssen sie zunächst eine Vergleichsbasis (Baseline) schaffen. Ein bewährter Ansatz besteht darin, die geplante Transportdauer für eine bestimmte Strecke heranzuziehen und diese um die bereits verstrichene Zeit anzupassen. Anschließend wird der Prognosefehler anhand dieser Baseline gemessen. Dieser Schritt ist entscheidend, da die Baseline als Maßstab für die Bewertung aller weiteren Modelle dient. Dazu werden der mediane ETA-Prognosefehler und die Abdeckung des 90. Perzentils (P90) nach Transportstrecke, Transportunternehmen und Prognosehorizont ermittelt und mit der Baseline verglichen. Übertrifft ein neues Modell die Baseline bei der Validierung anhand eines chronologisch getrennten Testdatensatzes, kann es produktiv eingesetzt werden. Andernfalls bleibt die Baseline im Einsatz.
Da hauptsächlich tabellarische Daten verarbeitet werden, eignen sich häufig Gradient-Boosted Trees. Um sowohl den Median als auch das 90. Perzentil vorherzusagen, kann Quantilsregression eingesetzt werden. Bei umfangreichen, kontinuierlich erfassten Telematikdaten können auch Sequenzmodelle hilfreich sein. Für die meisten Anwendungsfälle sind sie jedoch nicht erforderlich.
Welche Ergebnisse liefert das Modell? Es berechnet eine P50-ETA und eine P90-ETA sowie einen Indikator für die Zuverlässigkeit der Prognose. Die P50-ETA wird den Kunden angezeigt, während die P90-ETA für die Erkennung und Behandlung von Ausnahmefällen verwendet wird. Überschreitet beispielsweise bereits die P50-Prognose den zugesagten Liefertermin, sollte dies als Frühwarnsignal gelten und nicht lediglich als Bestätigung einer bevorstehenden Verspätung. Die konkreten Schwellenwerte hängen dabei von den betrieblichen Anforderungen ab, insbesondere davon, wie viele unerkannte Verspätungen und Fehlalarme toleriert werden können.
Die Zielwerte (Labels) müssen auf den tatsächlichen Zustellzeiten basieren. Die Eingangsmerkmale (Features) dürfen dagegen ausschließlich aus Daten gebildet werden, die dem Modell zum Zeitpunkt der jeweiligen Prognose bereits vorlagen. Ereignisse, die erst nach diesem Zeitpunkt eintreffen, dürfen bei der Berechnung nicht berücksichtigt werden.
Neuberechnung der ETA
Unmittelbar nach der ersten Prognose stellt sich die nächste Frage: Wann sollte die ETA aktualisiert werden?
Ein häufiger Fehler besteht darin, die ETA bei jedem eingehenden Telematiksignal neu zu berechnen und lediglich eine Verzögerung zwischen den Berechnungen pro Sendung einzuführen (Debouncing). Sinnvoller ist ein ereignisgesteuerter Ansatz. Dabei wird die ETA neu berechnet, wenn ein neuer Transportmeilenstein erreicht wird, sich die Position um mehr als einen festgelegten Schwellenwert verändert, eine Wetterwarnung oder eine Meldung über Verkehrsbehinderungen eingeht oder innerhalb von N Stunden kein neues Ereignis empfangen wurde und ein entsprechender Timer auslöst.
Jede ETA-Prognose sollte eine eigene Versionsnummer erhalten. Jede Änderung muss zusammen mit einem Ursachencode (Reason Code) gespeichert werden. Darüber hinaus sollte jede Prognose mit der Version des Sendungszustands gekennzeichnet sein, auf deren Grundlage sie berechnet wurde. Diese Versionsprüfung ist auch vor dem Speichern erforderlich: Ist die zugrunde liegende Version des Sendungszustands inzwischen veraltet, muss die Prognose verworfen und eine neue Berechnung eingeplant werden.
Erkennung von Verzögerungen und Anomalien
Im Folgenden werden typische Anwendungsfälle, die jeweiligen Erkennungssignale und die empfohlenen Standardmaßnahmen beschrieben:
- Verspätungsrisiko: Die P90-Prognose liegt nach dem zugesagten Liefertermin. In diesem Fall sollte das System einen Ausnahmefall zur Prüfung anlegen. Überschreitet der Schweregrad einen festgelegten Schwellenwert, muss der Kunde benachrichtigt werden.
- Stillstand einer Sendung: Innerhalb des erwarteten Zeitintervalls trifft kein neues Ereignis ein. In der Regel sollte das System die API des Transportunternehmens abfragen, um einen aktualisierten Sendungsstatus zu erhalten.
- Routenabweichung: Die aktuelle Position liegt außerhalb des vorgesehenen Routenkorridors. Das System sollte den Disponenten benachrichtigen, damit dieser die Ursache der Abweichung überprüfen kann.
- Fehlgeschlagene Übergabe: Eine Sendung trifft an einem Umschlagplatz ein, es wird jedoch kein anschließender Abgang registriert. In diesem Fall ist eine Eskalation an die zuständige Kontaktperson am Umschlagplatz erforderlich.
- Widersprüchliche Daten: In manchen Fällen werden einander widersprechende Statusmeldungen übermittelt. Das System sollte die weiterhin gültige ETA beibehalten, die betroffenen Daten als eingeschränkt zuverlässig kennzeichnen und zur Überprüfung weiterleiten.
Entwicklungsteams implementieren dafür üblicherweise zwei getrennte Ebenen. Die erste umfasst explizite Regeln, beispielsweise wenn die P90-Prognose außerhalb des zugesagten Lieferzeitfensters liegt, die Verweildauer an einem Umschlagplatz den für die Transportstrecke festgelegten Schwellenwert überschreitet, innerhalb des erwarteten Zeitintervalls kein neues Ereignis eingeht oder eine Sendung den vorgesehenen Routenkorridor verlässt.
Die zweite Ebene dient der statistischen Auswertung. Hier wird beispielsweise die Verweildauer einer Sendung mit der üblichen Verteilung für die jeweilige Transportstrecke verglichen. Statistische Ausreißer lassen sich anhand des Z-Scores oder des Interquartilsabstands (IQR) erkennen.
Die Regeln müssen verständlich und nachvollziehbar formuliert sein, damit das operative Team erkennen kann, warum eine bestimmte Warnung ausgelöst wurde, und den Ergebnissen des Systems vertrauen kann.
Workflows für das Exception Management in der Logistik
Ein Ausnahmefall sollte als eigenständiger Datensatz und nicht lediglich als Benachrichtigung behandelt werden. In den meisten Fällen reicht ein einfacher Zustandsautomat aus, um die verschiedenen Bearbeitungsstatus abzubilden: offen, bestätigt, in Bearbeitung, gelöst und verworfen. Darüber hinaus sollten die zugehörigen Metadaten gespeichert werden, darunter die ID und der Typ des Ausnahmefalls, sein Schweregrad, die betroffene Sendung, die auslösende Regel, der aktuelle Bearbeitungsstatus und ein SLA-Timer.
Änderungen an Ausnahmefällen und Aufträge zum Versand von Benachrichtigungen sollten innerhalb derselben Datenbanktransaktion mithilfe einer Outbox-Tabelle gespeichert werden. Damit bei erneuten Verarbeitungsversuchen keine Warnungen verloren gehen oder nachgelagerte Ereignisse doppelt ausgelöst werden, muss jeder Wiederholungsversuch einen Idempotenzschlüssel verwenden.
Die Datenbank sollte sicherstellen, dass pro Sendung und Ausnahmetyp jeweils nur ein aktiver Ausnahmefall gleichzeitig existiert. Entwickler implementieren dafür üblicherweise eine zentrale Methode, die den entsprechenden Datensatz erstellt oder aktualisiert. Sobald gültige Daten bestätigen, dass das auslösende Problem über einen festgelegten Zeitraum nicht mehr besteht, kann der Ausnahmefall geschlossen werden.
Ein leistungsfähiges System für das Exception Management in der Lieferkette fasst zusammenhängende Ausnahmefälle nach Umschlagplatz oder Transportstrecke zusammen, um ihre Bearbeitung zu erleichtern. Die Teams müssen einheitliche Schweregradstufen definieren und wiederholte Benachrichtigungen unterdrücken, damit die Benachrichtigungskanäle nicht mit Meldungen überlastet werden.
Auch eine automatisierte Bearbeitung von Ausnahmefällen in der Logistik ist möglich. Die konkrete Umsetzung hängt jedoch, wie bereits in einem vorherigen Abschnitt erläutert, vom jeweiligen Ausnahmetyp ab. Maßnahmen, die zusätzliche Kosten verursachen, erfordern eine besondere Behandlung und sollten erst nach einer manuellen Prüfung ausgeführt werden.
Einordnung in die Gesamtarchitektur
Die Herausforderungen bei der Entwicklung eines Systems für ETA-Prognosen gehen weit über die Auswahl des Prognosemodells hinaus. Die eigentliche Schwierigkeit besteht darin, sämtliche Systemkomponenten so miteinander zu verbinden, dass zuverlässige Vorhersagen möglich werden. Insbesondere die Zuordnung von Ereignissen und die Verarbeitung verspätet eintreffender Daten erfordern häufig einen erheblichen Teil der Entwicklungszeit.
Wer nicht nur den aktuellen Standort einer Sendung kennen, sondern auch ihren weiteren Transportverlauf vorhersagen möchte, sollte mit einer zuverlässigen Ereignisverarbeitung beginnen und darauf aufbauend die ETA-Prognose implementieren.