KI in Unternehmenssysteme integrieren Architektur und praktische Umsetzung
Als Unternehmen begannen, KI in ihre Softwarelösungen zu integrieren, gingen Entwicklungsteams für Unternehmenssoftware meist schrittweise vor: Hier wurde ein Chatbot eingebunden, dort eine Empfehlungsfunktion ergänzt. Doch mit der Weiterentwicklung der KI-Modelle verändern sich auch die Ansätze für ihren Einsatz.
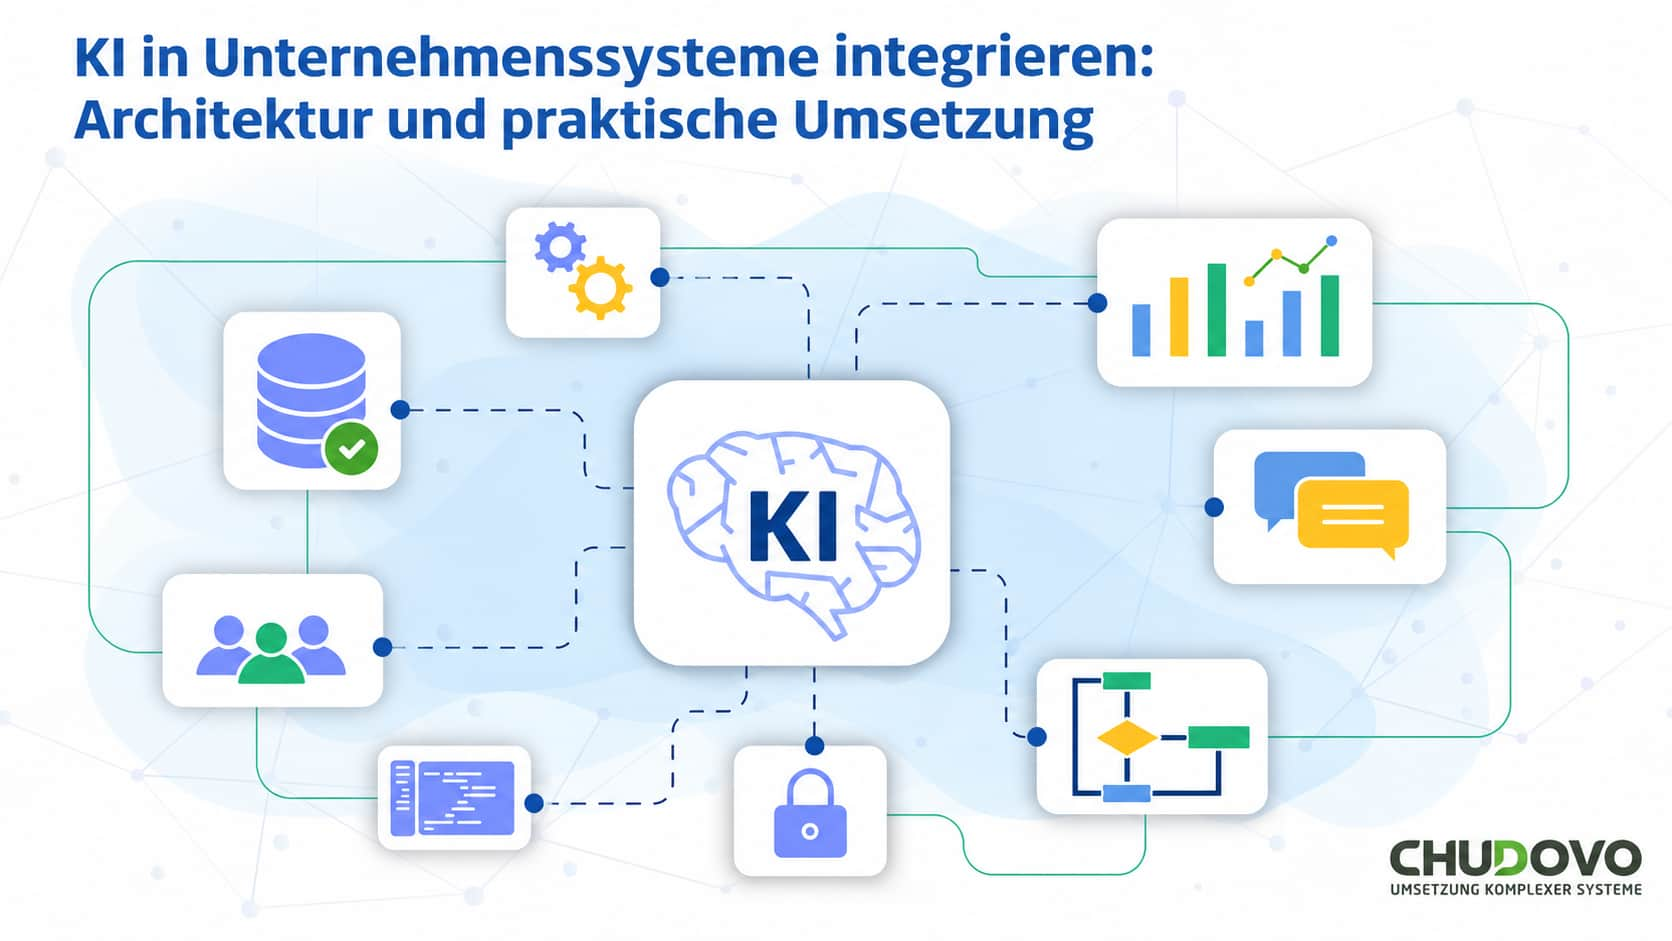
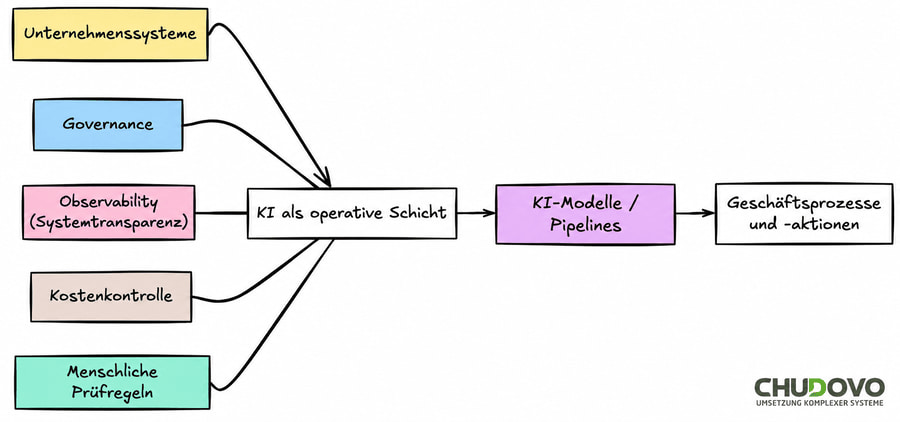
Inzwischen geht der Trend weg von einzelnen KI-Funktionen hin zu KI als übergreifender operativer Schicht. Statt auf eine bestimmte Anwendung beschränkt zu sein, kann KI auf diese Weise verschiedene Systeme und deren Funktionen miteinander verbinden und unterstützen.
Je stärker Unternehmen KI in ihre Geschäftsprozesse einbinden, desto mehr rückt eine neue Herausforderung in den Vordergrund: Es geht nicht mehr nur darum, einzelne KI-Anwendungen zu erproben, sondern ihren einheitlichen Einsatz über verschiedene Systeme, Teams und Anwendungsfälle hinweg sicherzustellen. Das volle Potenzial entfaltet KI vor allem dann, wenn sie als gemeinsam genutzte Infrastruktur verstanden wird. Dafür sollten grundlegende Entscheidungen zur Orchestrierung, Governance und Datenverarbeitung frühzeitig und gezielt getroffen werden – und nicht erst dann, wenn im laufenden Betrieb Probleme auftreten oder die Skalierung an ihre Grenzen stößt.
In den folgenden Abschnitten erläutern wir, wie Chudovo diesen Ansatz betrachtet. Dabei gehen wir auf die Rolle der Orchestrierung, die Anforderungen an eine wirksame Governance, die Bedeutung klar definierter Datengrenzen sowie die Kosten ein, die beim Einsatz von KI in größerem Maßstab entstehen.
Was ist eine KI-Orchestrierungsschicht?
Vereinfacht gesagt ist eine operative Schicht ein Bestandteil der Systemarchitektur, der zwischen zwei anderen Komponenten liegt. Auf der einen Seite befinden sich in der Regel die Kernsysteme oder Datenbestände, auf der anderen die Schnittstellen und Prozesse, die auf diese zugreifen.
Die Hauptaufgabe dieser Schicht besteht darin, die Kommunikation zwischen beiden Seiten zu steuern. Sie übernimmt die Koordination, die Übersetzung zwischen unterschiedlichen Formaten, die Durchsetzung von Regeln und die Weiterleitung von Anfragen und Daten.
Wird KI in diese Schicht integriert, soll sie weit mehr leisten als nur Fragen zu beantworten. Sie soll wertvolle Erkenntnisse liefern und aktiv in bestehende Arbeitsabläufe eingebunden werden. Das kann beispielsweise so aussehen:
- Ein KI-Modell bewertet eingehende Supportanfragen, ordnet sie nach Priorität und aktualisiert die entsprechenden Einträge im CRM-System
- Eine KI-Pipeline überprüft Vertragsformulierungen, bevor ein Dokument zur rechtlichen Prüfung weitergeleitet wird
- Ein Klassifizierungssystem versieht Transaktionen nahezu in Echtzeit mit passenden Kategorien, damit nachgelagerte Compliance-Prüfungen durchgeführt werden können
In all diesen Fällen verarbeitet das KI-Modell Informationen aus mehreren Systemen, wendet bestimmte Regeln und Logiken an und liefert Ergebnisse, die den weiteren Ablauf beeinflussen. Genau darin liegt der übergreifende Mehrwert, den KI bieten kann.
Während eine KI-Funktion innerhalb einer einzelnen Anwendung vor allem präzise Ergebnisse liefern muss, werden an KI als operative Schicht deutlich höhere Anforderungen gestellt. Neben der Genauigkeit spielen auch Nachvollziehbarkeit, Wiederherstellbarkeit, Observability und Kostenkontrolle eine entscheidende Rolle. Es reicht also nicht mehr, nur zu fragen: „Hat das Modell die richtige Antwort geliefert?“ Viel wichtiger ist, dass sich nachvollziehen und belegen lässt, was die KI getan hat, und dass fehlerhafte Entscheidungen bei Bedarf rückgängig gemacht werden können.
Die Herausforderungen der KI-Orchestrierung
Wer KI in Unternehmenssysteme integrieren und in größerem Maßstab einsetzen möchte, benötigt eine zentrale operative KI-Schicht. Ohne eine solche Architektur besteht die Gefahr, dass KI-Aufrufe über verschiedene Codebasen verteilt sind, Fehlerbehandlungen uneinheitlich umgesetzt werden und ein zentraler Überblick über auftretende Probleme fehlt. Auch Änderungen an bestehenden Richtlinien lassen sich dann kaum durchsetzen, ohne jeden einzelnen Service anpassen zu müssen.
Eine gut konzipierte KI-Orchestrierungsschicht kann dabei folgende Aufgaben übernehmen:
- Routing: Festlegen, welches KI-Modell oder welche Pipeline für die Bearbeitung einer bestimmten Anfrage zuständig ist.
- Retry- und Fallback-Logik: Steuern, was passiert, wenn ein Modellaufruf fehlschlägt oder ein Ergebnis mit geringer Zuverlässigkeit liefert.
- Prompt-Management: Prompts versionieren und ihre Bereitstellung in verschiedenen Umgebungen verwalten.
- Rate Limiting und Throttling: Plötzliche Kostensteigerungen verhindern und sicherstellen, dass die Systemleistung auch bei hoher Auslastung stabil bleibt.
- Logging und Tracing: Transparenz darüber schaffen, was in den einzelnen Schritten einer Pipeline passiert ist.
Das folgende Beispiel ist vereinfacht, veranschaulicht jedoch einen typischen Architekturansatz. Das Team von Chudovo setzt bei Unternehmensprojekten häufig auf dieses Muster, wenn mehrere KI-Services eine gemeinsame Routing-Logik nutzen sollen, ohne diese in jedem Service separat implementieren zu müssen.
// Simplified orchestration dispatcher
const pipelines = {
contract_review: contractReviewPipeline,
support_triage: supportTriagePipeline,
transaction_flag: transactionClassificationPipeline,
};
async function routeRequest(requestType, payload) {
const handler = pipelines[requestType];
if (!handler) {
throw new Error(`No handler registered for: ${requestType}`);
}
try {
const result = await handler(payload);
logEvent(requestType, payload, result, { status: "success" });
return result;
} catch (err) {
logEvent(requestType, payload, {}, { status: "error", error: err.message });
throw err;
}
}Dieser Ansatz ermöglicht eine zentrale Überwachung der KI-Prozesse und zeigt, wie eine gut strukturierte KI-Orchestrierungsschicht in der Praxis aussehen kann.
KI-Governance-Framework
Viele Unternehmen sprechen über verantwortungsvolle KI-Governance, doch nur wenige setzen entsprechende Maßnahmen tatsächlich um. Eine einzelne KI-Komponente lässt sich noch relativ einfach kontrollieren. Sind jedoch zehn verschiedene Komponenten im Einsatz, die von unterschiedlichen Teams betreut werden und auf Modelle verschiedener Anbieter zurückgreifen, wird die Situation deutlich komplexer. Mit zunehmender Größe des Systems steigt auch der Aufwand für dessen Steuerung und Kontrolle.
Eine solide Governance für KI in Unternehmenssystemen beginnt mit klaren Richtlinien zur Herkunft und Versionierung der Modelle sowie zur Zugriffskontrolle. Dabei muss nachvollziehbar sein, welche Modellversion zu welchem Zeitpunkt ein bestimmtes Ergebnis erzeugt hat. Ebenso muss eindeutig geregelt sein, welche Systeme und Benutzer auf welche KI-Funktionen zugreifen dürfen.
Das allein reicht jedoch nicht aus. Unternehmen benötigen außerdem klare Regeln dafür, welche Aktionen KI in bestimmten Situationen ausführen darf und wo ihre Befugnisse enden. Erkennt ein Modell beispielsweise verdächtige Transaktionen, darf es nicht ohne vorherige menschliche Prüfung automatisch Konten sperren.
Für Audit-Zwecke müssen die Ergebnisse der KI-Modelle manipulationssicher dokumentiert werden. Ergänzend ist ein Monitoring erforderlich, mit dem sich erkennen lässt, ob die Qualität der Modellergebnisse im Laufe der Zeit nachlässt.
Ein möglicher Ansatz besteht darin, für jede KI-Pipeline verbindliche Governance-Regeln festzulegen. Diese müssen nicht besonders umfangreich sein, sondern vor allem in der Praxis funktionieren. Oft genügt bereits eine kompakte Spezifikation, die die verwendete Modellversion, den Speicherort der Audit-Logs, die Regeln für erneute Ausführungsversuche, die Eskalationswege sowie die Bedingungen für eine notwendige menschliche Überprüfung festhält.
const contractReviewGovernance = {
  modelVersion: "claude-sonnet-4-20250514",
  auditLog: {
    destination: "s3://audit-logs/contract-review",
    retentionDays: 365,
  },
  retryPolicy: {
    maxAttempts: 3,
    backoffMs: 500,
  },
  escalation: {
    triggerOnConfidenceBelow: 0.75,
    notifyChannel: "legal-review-queue",
  },
  requiresHumanReview: (result) => result.flagCount > 0,
};
Das obige Beispiel zeigt einen kleinen, aber konkreten Bestandteil eines umfassenderen KI-Governance-Frameworks. Besonders wichtig ist dabei die Bedingung requiresHumanReview. Sie legt fest, welche Entscheidungen die KI selbstständig treffen darf und wann ein Mensch eingreifen muss. Diesen Schwellenwert richtig zu definieren, ist entscheidend. Wird er zu hoch oder zu niedrig angesetzt, kann das zu Problemen führen. Genau solche Fehleinschätzungen gehören zu den häufigsten Fehlern, wenn Teams von einer einzelnen KI-Pipeline zu einem produktiv eingesetzten System übergehen.
Datengrenzen in KI-Systemen
Wenn es einen Bereich gibt, in dem theoretische Konzepte auf die Realität großer Unternehmen treffen, dann ist es der Umgang mit Datengrenzen.
Damit KI-Modelle einen echten Nutzen bieten können, benötigen sie Zugriff auf Daten. Besonders wichtig ist das bei großen Sprachmodellen, die in Retrieval-Augmented-Generation-Pipelines (RAG) eingesetzt werden. Gleichzeitig verfügen die meisten größeren Unternehmen über Daten, die bestimmte Grenzen nicht überschreiten dürfen – sei es aufgrund gesetzlicher Vorschriften, vertraglicher Verpflichtungen, interner Richtlinien oder Vereinbarungen mit Kunden.
Hier entsteht ein offensichtlicher Zielkonflikt, der sich allerdings nicht von selbst lösen lässt. Unternehmen müssen ihn mit konkreten Maßnahmen angehen. Unserer Erfahrung nach müssen Organisationen, die Datengrenzen bei der Gestaltung ihrer Enterprise-Datenarchitektur zunächst außer Acht lassen, die entsprechenden Schutzmechanismen später nachträglich integrieren. Das ist in der Regel mit deutlich höheren Kosten verbunden.
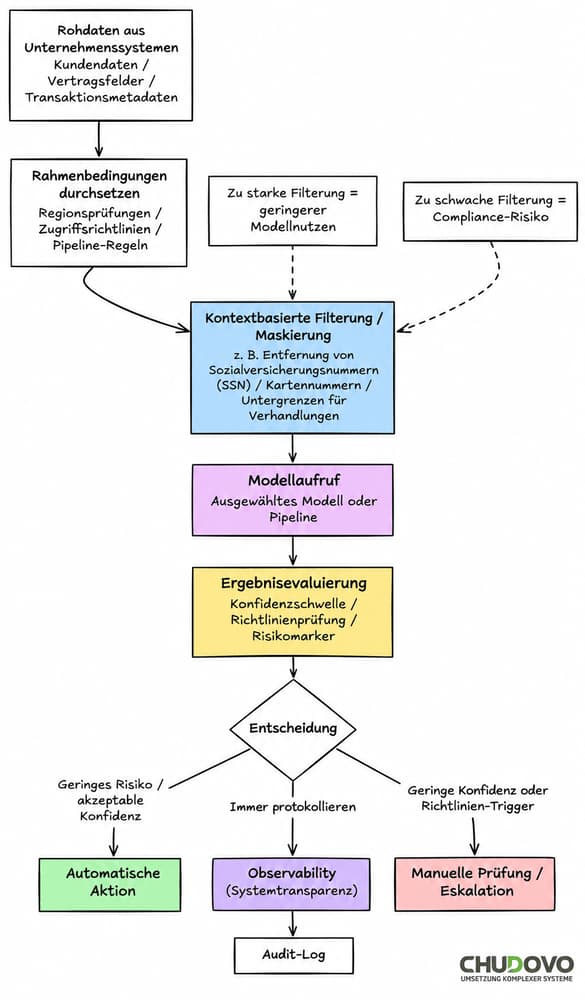
Eine der gängigsten, aber auch anspruchsvollsten Methoden, um solche Datengrenzen einzuhalten, ist das kontextbezogene Filtern (Contextual Filtering). Das folgende Beispiel zeigt, wie dieser Ansatz funktioniert:
function applyContextualFilter(payload, pipelineType) {
const sensitiveFields = {
support_triage: ["creditCardNumber", "ssn", "bankAccountId"],
contract_review: ["internalCostBasis", "negotiationFloor"],
};
const fieldsToRemove = sensitiveFields[pipelineType] ?? [];
// In practice, fields may be removed or masked depending on schema requirements
return Object.fromEntries(
Object.entries(payload).filter(([key]) => !fieldsToRemove.includes(key))
);
}
// Usage before routing
const filteredPayload = applyContextualFilter(rawPayload, "support_triage")Bei dieser Methode werden sensible Datenfelder entfernt oder maskiert, bevor die Informationen an das KI-Modell weitergegeben werden. Das ist beispielsweise besonders hilfreich, um Kundendaten in Support-Prozessen unkenntlich zu machen. Allerdings gibt es dabei eine wichtige Herausforderung: Werden zu viele Informationen entfernt, fehlt dem Modell der notwendige Kontext, um brauchbare Ergebnisse zu liefern. Am obigen Beispiel wird dieser Zielkonflikt deutlich: Wenn ein KI-Modell zur Klassifizierung von Supportanfragen den Kontotyp eines Kunden nicht erkennen kann, kann es Anfragen von Großkunden und kleinen und mittleren Unternehmen (KMU) nicht mehr zuverlässig den richtigen Bearbeitungswegen zuordnen. Im Produktivbetrieb führt dies zu einer spürbaren Zahl an Fehlklassifizierungen.
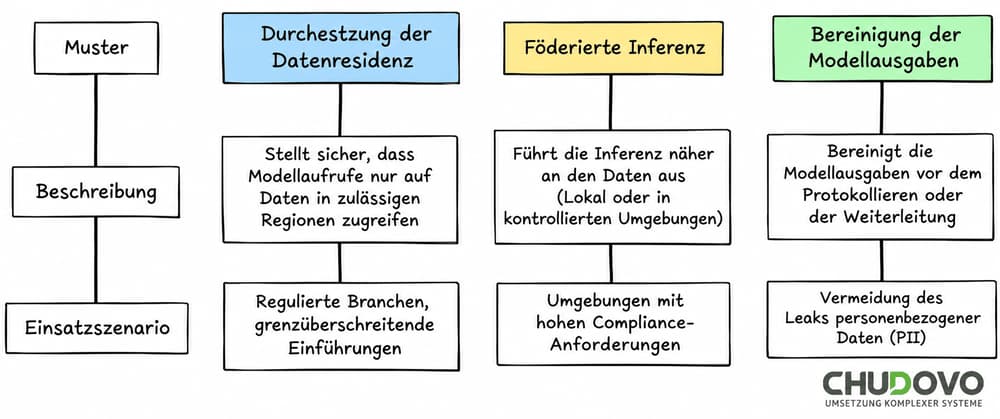
Darüber hinaus gibt es weitere bewährte Ansätze für KI-Compliance und Risikomanagement.
KI-Infrastrukturmanagement
Der Betrieb einer einzelnen KI-gestützten Funktion ist in der Regel so kostengünstig, dass dafür meist kein eigenes Budget eingeplant werden muss. Anders sieht es aus, wenn KI als operative Schicht aufgebaut und dauerhaft betrieben werden soll.
Die Kosten für den Einsatz von KI in Unternehmenssystemen werden hauptsächlich von drei Faktoren bestimmt:
- Inferenz
- Latenz
- Observability
Am offensichtlichsten sind die Inferenzkosten. Die tokenbasierte Preisgestaltung großer LLM-Anbieter kann insbesondere bei KI-Pipelines, die täglich eine hohe Anzahl von Anfragen verarbeiten, schnell zu erheblichen Ausgaben führen.
Betrachten wir folgendes Beispiel:
- Eine KI-Pipeline verarbeitet täglich 100.000 Anfragen bei einem Preis von 0,01 US-Dollar pro 1.000 Token.
- Pro Anfrage werden durchschnittlich 500 Token verbraucht.
Daraus ergeben sich Kosten von rund 500 US-Dollar pro Tag – allein für diese eine Pipeline. Werden mehrere solcher Pipelines betrieben, können die gesamten Infrastrukturkosten schnell beträchtliche Ausmaße annehmen.
Gleichzeitig müssen operative KI-Systeme häufig strenge Anforderungen an kurze Antwortzeiten erfüllen. In der Praxis kann das bedeuten, dass mehrere Instanzen eines Modells parallel betrieben werden müssen. Eine andere Möglichkeit besteht darin, ein günstigeres, aber weniger leistungsfähiges Modell für die erste Einordnung von Anfragen und einfache Aufgaben einzusetzen. Nur bei komplexeren Fällen wird die Verarbeitung dann an ein leistungsfähigeres und entsprechend teureres Modell weitergegeben.
Beide Ansätze können sinnvoll sein, allerdings auch die durchschnittlichen Kosten pro Anfrage erhöhen.
Hinzu kommen die Infrastrukturkosten für ein gut durchdachtes Observability-System. Dazu gehören unter anderem zentralisiertes Logging, die Speicherung von Tracing-Daten, das Monitoring der KI-Modelle sowie Werkzeuge zur Umsetzung von Governance-Anforderungen.
All diese Kostenfaktoren werden in der frühen Planungsphase häufig unterschätzt. Nach den Erfahrungen von Chudovo erfordert der Aufbau einer skalierbaren KI-Infrastruktur, die Kosten nicht als einmalige Schätzung, sondern als laufenden Bestandteil des Betriebs zu betrachten. Kostenmodelle sollten deshalb für jede Pipeline einzeln und nicht pauschal für das gesamte Deployment erstellt werden. Dabei müssen der Tokenverbrauch, die Häufigkeit von Fallbacks und die Anzahl der Eskalationen berücksichtigt werden. Ergänzend sollten automatische Budgetwarnungen eingerichtet werden, um unerwartete Kostenspitzen frühzeitig zu erkennen.
KI in bestehende Unternehmenssysteme integrieren – ohne vollständige Neuentwicklung
Wer ein System von Grund auf neu entwickelt, kann KI relativ einfach als operative Schicht integrieren. Die KI wird von Anfang an im Entwicklungsprozess berücksichtigt, und der Technologie-Stack lässt sich entsprechend auf diese Integration ausrichten.
Die eigentliche Herausforderung besteht darin, eine solche Schicht in ein bereits bestehendes und produktiv eingesetztes System einzubinden.
Dabei stellt sich häufig die Frage: Muss dafür die gesamte Systemarchitektur neu gestaltet werden? Die Antwort lautet: Es kommt auf die vorhandene Architektur an.
Handelt es sich um ein monolithisches System mit eng miteinander verknüpften Komponenten, kann die Integration aufwendig werden. Schließlich muss die KI-Schicht über Schnittstellen eingebunden werden, die ursprünglich nicht für diesen Zweck vorgesehen waren. Das lässt sich durchaus lösen, erfordert jedoch häufig die Entwicklung zusätzlicher Adapterschichten. Dadurch entsteht langfristig ein zusätzlicher Wartungsaufwand, der mit der Zeit weiter zunimmt.
Anders sieht es aus, wenn das bestehende System bereits auf einer ereignisgesteuerten Architektur, Message Queues oder Service Meshes basiert. In diesem Fall lässt sich die KI-Orchestrierung meist ohne größere Eingriffe in die bestehende Architektur integrieren. Die KI-Komponenten können als Empfänger oder Erzeuger von Ereignissen an die vorhandenen Event-Busse angebunden werden. Die Orchestrierungsschicht ergänzt somit die bestehende Infrastruktur, ohne sie grundlegend verändern zu müssen.
In beiden Fällen bietet eine schrittweise Integration von KI in Unternehmenssysteme deutlich bessere Möglichkeiten, bei Problemen zum vorherigen Zustand zurückzukehren, als eine vollständige Umstellung auf einmal. Sinnvoll ist es, zunächst mit einer klar abgegrenzten, nicht geschäftskritischen Pipeline zu beginnen und diese mit geeigneten Monitoring- und Tracing-Funktionen auszustatten. Anschließend sollten das Kostenverhalten und mögliche Fehlerquellen analysiert werden, bevor die KI-Integration auf weitere Bereiche ausgeweitet wird.
Aufbau einer zukunftssicheren Enterprise-KI-Architektur
Um KI erfolgreich in Unternehmenssoftware zu integrieren, reicht es nicht aus, ein Modell einfach mit einer bestehenden Pipeline zu verbinden. Auch Observability, Governance, Datenarchitektur und Kostenmanagement müssen von Anfang an berücksichtigt werden. Die damit verbundenen Herausforderungen entstehen nicht erst nach und nach, sondern zeigen sich häufig schon kurz vor der ersten Bereitstellung im Produktivbetrieb.
Die Entscheidungen, die bei der Entwicklung der ersten KI-Pipeline getroffen werden, geben oft die Richtung für alle weiteren Integrationen vor. Wie die Orchestrierung aufgebaut ist, welche Governance-Regeln gelten und wie Datengrenzen definiert werden, beeinflusst die gesamte weitere Entwicklung. Werden hier falsche Entscheidungen getroffen, können später erhebliche Probleme und zusätzliche Kosten entstehen. Besonders schwierig ist dabei, dass das Team, das die erste Pipeline entwickelt, häufig nicht für die nächste verantwortlich ist.
Je weiter sich KI im Unternehmen verbreitet, desto häufiger müssen verschiedene Teams mit Architekturentscheidungen arbeiten, die sie selbst nicht getroffen haben. Genau deshalb lohnt es sich, frühzeitig klare Vorgaben für die Orchestrierung und Governance festzulegen. Eine gut dokumentierte Pipeline lässt sich von anderen Teams problemlos übernehmen, überprüfen und erweitern. Eine schlecht strukturierte Pipeline hingegen wird schnell zur Blackbox, an der niemand gerne Änderungen vornimmt. Das eigentliche Problem liegt daher meist nicht beim KI-Modell selbst, sondern bei der Infrastruktur, die seinen Einsatz ermöglicht.
Sobald diese Infrastruktur aufgebaut ist, bildet sie die Grundlage für alle zukünftigen KI-Initiativen im Unternehmen. Sie von Anfang an durchdacht zu gestalten, hat nichts mit übertriebenem Perfektionismus zu tun. Vielmehr geht es darum, eine Architektur zu schaffen, die sich langfristig erweitern lässt, ohne dass jede neue Funktion zusätzliche Schwierigkeiten verursacht.
Unternehmen, die diese Faktoren bei der Integration von KI bewusst und frühzeitig berücksichtigen, können ihre Lösungen in der Regel wesentlich reibungsloser skalieren als Unternehmen, die sich erst später mit den Anforderungen an die Infrastruktur beschäftigen.